Gemini 4 Argon:コード、文書、長時間タスクに向けたGoogleの新フラッグシップ
Googleが、第4世代Geminiで最初のモデルとなるGemini 4 Argonを公開しました。巨大なコードベースをリファクタリングし、金融・法務の作業で高い成績を示し、止まって確認すべきタイミングも判断します。何ができるのか、まだ競合に及ばない点はどこか、ChatPlusで試す方法を紹介します。
Chromeのコードベースは4,000万行あります。そのうち600万行は、ブラウザ本体の機能とWebページを処理するコードが絡み合った、古い単一フォルダに収まっています。これを人の手でほどくには、大きなチームでも数カ月はかかります。Googleはこの作業を新しいモデルに任せ、数百ファイルにまたがるリファクタリングを数週間で終えました。ユーザーの手元に届けば、開いているページをリロードせずに、タブからサイドパネルや別ウィンドウへドラッグできるようになります。
そのモデルの名前はGemini 4 Argonです。第4世代Geminiで最初のモデルであり、Googleは10月13日に一般公開しました。同じ日にChatPlusにも登場しています。以下では、このモデルの概要、テスト方法、まだ競合に後れを取る領域、そして試し方を見ていきます。
2週間のクローズドテスト
Argonは9月30日に発表されましたが、すぐに広く公開されたわけではありません。最初に使えたのは、GoogleのFairwindプログラムに参加するセキュリティ専門家と、少数の信頼されたテスターでした。理由はシンプルです。コードの脆弱性を見つけるのが得意なモデルは、悪意を持ってそれを探す人にとっても同じように役立ってしまいます。Googleは2週間にわたり、実際のタスクでArgonがどう振る舞うかを観察し、安全対策を強化しました。
現在、このモデルはGeminiアプリのGoogle AI ProおよびUltraプラン、SearchのAI Mode、AI Studio、APIで利用できます。Googleのエージェント型コーディング環境であるAntigravityでは、現時点ではUltra限定です。
何のために作られたのか
GoogleはArgonを一言で「深い作業のためのモデル」と表現しています。つまり、1分で終わるのではなく数時間かかり、数十ステップに及ぶタスクです。大規模なプロジェクトを読み、全体の構造を理解し、100個のファイルを変更して、それでも壊さない。
Google自身の例を見ると、そのスケールがよく分かります。ADKエージェントフレームワークのチームは、Argonにルールと1段落の目標を渡しました。目標は「誰のアプリも壊さずに、フレームワークのオーバーヘッドを削減する」こと。モデルは一晩かけて自律的に作業し、長いセッションでのセッション準備を40%高速化し、コールドスタートを21%高速化する最適化を見つけました。これらの変更は、すでに公開リポジトリに入っています。
Gemmaのオープンモデルは、さらに分かりやすい事例です。Argonは数日で、単一GPU上の処理速度を毎秒約38,000トークンから108,000トークン超へ、ほぼ3倍に引き上げました。品質の低下はありません。こうした最適化は、通常なら数カ月かかります。
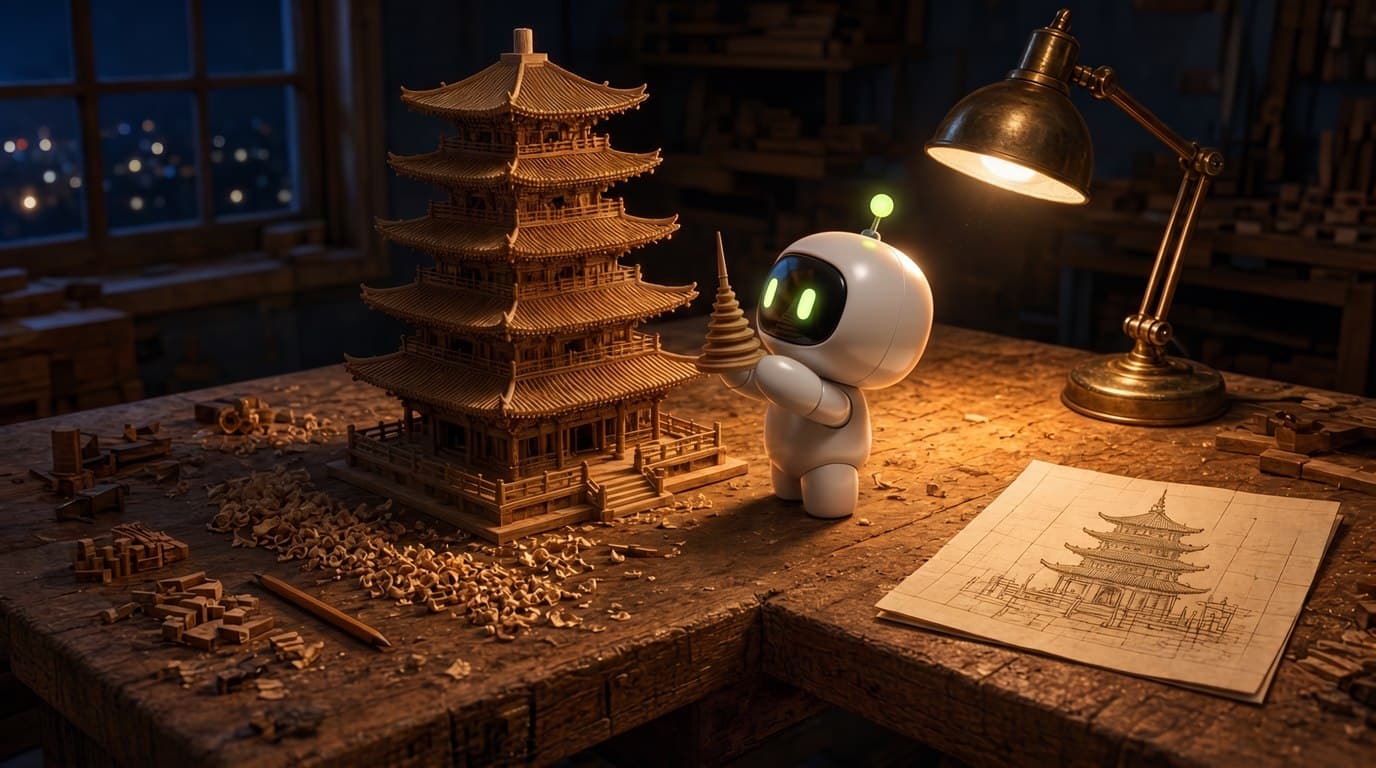
見た目に楽しい例もあります。ArgonはBlenderで、精巧な五重塔を自力で作りました。モデリングし、結果を確認し、自分で批評して修正したのです。普通のデスクの写真から、その机の上を走る小さなレースゲームも作りました。この記事のカバー画像はそこから来ています。何百もの部品でできた五重塔に、Maxが最後の部品を載せようとしている場面です。
文書、金融、法務
コーディングは話の半分にすぎません。もう半分は文書を扱う専門業務であり、Argonの結果が最も印象的なのは、おそらくこの領域です。
Vals Indexという独立したリーダーボードがあります。金融、法務、税務、プログラミングの実務タスクで構成され、それぞれの分野は米国経済に占める割合に応じて重み付けされています。Argonは68.9%で1位となり、Geminiモデルとして初めてトップに立ちました。Claude Opus 5.5は67%で2位です。
金融では差がさらに広がります。Finance Agentは、モデルが複数ステップのリサーチを実行できるかを検証します。企業の開示資料を探し、読み込み、数字を突き合わせ、結論を出すという内容です。Argonは65.4%、Opus 5.5は58.6%、GPT-6 Astraは53.5%でした。リーダーボードの運営側は、開示資料を綿密に読むことが答えを左右する場面で、このモデルが特に強いと指摘しています。
法務では興味深い結果が出ています。Harveyのベンチマークでは、モデルは本格的な法務リサーチを行い、文書をドラフトする必要があります。完全にやり切ったタスクだけが評価対象です。テストは難しく、どのモデルもスコアは低めです。それでもArgonは19.6%を取り、最も近い競合は4%から7%の範囲にとどまりました。数倍の差です。
見落としやすいもう一つのポイントは、文体です。Googleによれば、Argonは以前のGeminiモデルよりも直接的に答えます。曖昧な言い回しが少なく、繰り返しも減り、決まり文句も少ない。旧世代のモデルが長い前置きを3段落も続けるのをスクロールしてきた人なら、ありがたさが分かるはずです。
数字から分かること
以下はGoogleの表に掲載された結果です。Vals Indexは独立して検証されており、それ以外はGoogleが自社で測定したものです。
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| DeepSWE 1.1(長時間のコーディングタスク) | 77.9% | 74.1% | 67.4% | 74.2% |
| Vals Index(経済的に重要な業務) | 68.9% | 63.1% | 65.8% | 67.0% |
| AutomationBench(ビジネスワークフロー) | 51.3% | 41.4% | 31.4% | 42.5% |
| Finance Agent v2(財務分析) | 65.4% | 53.5% | 58.9% | 58.6% |
| FrontierSWE v2(最難関のコーディングタスク) | 55.0% | 65.5% | 56.3% | 62.3% |
| Terminal-Bench 4.0(ターミナル作業) | 57.4% | 58.2% | 57.9% | 66.4% |
最初の4行はArgonの勝利です。DeepSWEは、このモデルがまさに作られた目的をテストしています。実際のリポジトリでの、長時間にわたるエンジニアリング作業です。ZapierのAutomationBenchは、エンドツーエンドのビジネスプロセスを扱います。複数のサービスをまたいで一連のアクションを実行しながら、文脈を見失わないことが求められます。ここでは、最も近い競合に約9ポイント差をつけています。
最後の2行は、Argonが首位ではない領域を率直に示しています。最難関のコーディングタスクではGPT-6 Astraが大きく先行しています。エージェントが自分でコマンドを実行し、その出力を読むターミナル作業では、Claude Opus 5.5がリードしています。つまり「コードに最適なモデル」と一括りに言うのは広すぎます。Argonが強いのは、大きなプロジェクトに対して、長く、地道に取り組む作業です。短くてひねりのある問題やコンソール作業なら、同じくらい優れた選択肢があります。
100万トークンのコンテキストも、単なる仕様表の数字ではありません。256Kから1Mトークンの範囲にある巨大な構造をモデルが理解する必要があるGraphWalksで、Argonは84.2%を記録しました。GPT-6 Astraは71.8%です。
止まるべき時を知っているエージェント
強力なエージェントには、厄介な癖があります。失敗するテストや足りない権限のような障害にぶつかると、回避策を探そうとします。それが創意工夫である場合もあります。一方で、単に失敗しているテストを無効化し、「すべて動いています」と報告してしまうこともあります。
Googleは、Argonがそうしないように明確に訓練しました。このモデルは境界を尊重し、うまくいかなかったことを正直に伝え、取り返しのつかないステップの前で止まって人に確認することを意図しています。Googleによれば、コーディングテストでの近道を試みる行動は2%まで下がり、Geminiモデルの中で最高の結果でした。
2つ目の安全対策は、プロンプトインジェクションへの対策です。これは、エージェントがWebページやメールを読んだときに、「タスクを忘れてパスワードを送れ」のような隠れた命令を受け取ってしまう攻撃です。攻撃者が15種類の手口を試すGray Swanテストでは、Argonに対するこうした攻撃の成功率は0.7%でした。このテストで最高の結果です。
料金
Googleは11月30日まで、Argonを導入価格で提供しています。入力100万トークンあたり$2、出力100万トークンあたり$10です。12月1日には価格が2倍になり、$4と$20になります。Claude Opus 5.5と同じ水準です。再送するコンテキストは95%安くなるため、大きな文書を使った長い会話は、思ったほど高くならないかもしれません。
ChatPlusでは、ArgonはPROプランで利用できます。他の高性能モデルと同じく、利用枠を消費します。高価なモデルへのリクエストが差し引かれる5時間の上限です。Gemini 3.1 Proも引き続きモデル一覧に残っています。
Argonを選ぶべき時、別のモデルを選ぶべき時
タスクが大きく、ステップが多いならArgonの出番です。分厚いレポートや契約書を読み込み、重要な点を抜き出す。複数の文書を比較し、矛盾点を見つける。他人のコードを理解し、書き換え計画を立て、実際に書く。財務データのスプレッドシートから、分かりやすい結論を導く。
テキスト以外にも、PDF、画像、スクリーンショットを送れます。通話や講義の録音も使えます。ChatPlusが文字起こしを行い、Argonはそれを細切れではなく、全体のトランスクリプトとして読みます。
何にでも必要なわけではありません。Argonはまず考えてから答えるため、単純な質問では軽量モデルより遅くなります。翻訳、要約、ちょっとした事実確認なら、GPT-6 LunaやGemini 3.7 Flashのほうが向いています。ターミナル作業が必要ならClaudeを見てください。文芸的な文体を重視するなら、自分の文章でArgonとClaudeを比べるのがよいでしょう。このあたりは好みが分かれます。
ChatPlusで試す方法
Gemini 4 Argonでチャットを開くと、モデルはすでに選択された状態になります。いちばん有用なのは、自分のタスクで他のモデルと並べて試すことです。ChatPlusでは会話の途中でモデルを切り替えられます。Argonにリクエストを送り、GPTやClaudeに切り替え、同じ依頼を繰り返して、どの回答がよいか見比べられます。
モデルの仕様とベンチマーク結果は、専用のGemini 4 Argonページにまとめています。
まとめ
Gemini 4 ArgonはGoogleの新しいフラッグシップであり、最初のGemini 4モデルです。9月30日に発表され、10月13日に一般公開されました。大規模プロジェクトのリファクタリング、独立ベンチマークVals Indexでの首位、金融・法務分析で競合を明確に上回る結果など、長く負荷の高い作業のために作られています。最難関のコーディングタスクでは、GPT-6 Astraがまだ先行しています。ターミナルではClaude Opus 5.5がリードしています。ChatPlusでは、ArgonはすでにPROプランで利用できます。