Gemini 4 Argon:Google 面向代码、文档和长任务的新旗舰模型
Google 已开放 Gemini 4 Argon,这是第四代 Gemini 的首个模型。它能重构庞大的代码库,在金融和法律任务上领先,也知道什么时候该停下来发问。下面看看它能做什么、哪些地方仍落后于对手,以及如何在 ChatPlus 上试用。
Chrome 的代码库有四千万行代码。其中六百万行放在一个老旧文件夹里,浏览器自身功能和处理网页的代码缠在一起。要靠人手把它们理清楚,一个大型团队也得忙上好几个月。Google 把这项工作交给了它的新模型,跨数百个文件的重构用了几周就完成了。等这项改动推送给用户后,你就可以把已打开的页面从标签页拖到侧边栏或独立窗口里,而且不需要重新加载。
这个模型叫 Gemini 4 Argon。它是第四代 Gemini 的首个模型,Google 于 10 月 13 日向所有人开放。它也在同一天登陆 ChatPlus。下面我们会讲:这个模型是什么、它是怎么测试的、目前在哪些地方还落后于竞争对手,以及怎样试用。
幕后封闭测试两周
Argon 在 9 月 30 日发布,但一开始没有大范围开放。最早拿到它的是 Google Fairwind 计划里的安全专家,以及一小部分受信任的测试者。原因很简单:一个擅长在代码里找漏洞的模型,对怀有恶意、想找漏洞的人同样有用。Google 用两周时间观察 Argon 在真实任务中的表现,并收紧它的安全保护。
现在,这个模型已可在 Google AI Pro 和 Ultra 方案的 Gemini app、Search 的 AI Mode、AI Studio 以及 API 中使用。在 Google 用于智能体编程的环境 Antigravity 里,目前只有 Ultra 可用。
它是为哪些任务打造的
Google 用一句话概括 Argon:面向深度工作的模型。也就是那些不是一分钟就能完成,而是要花好几个小时、包含几十个步骤的任务。读懂一个大型项目,理解各部分如何配合,修改一百个文件,同时不把东西弄坏。
Google 自己给出的例子很好地说明了它的规模。ADK 智能体框架团队把规则和一段目标交给 Argon:在不破坏任何人应用的前提下,降低框架开销。模型通宵独立工作,找到了多项优化,让长会话中的 session 准备速度提升 40%,冷启动速度提升 21%。这些改动已经进入公开代码仓库。
Gemma 开源模型是更直观的案例。短短几天内,Argon 让它们的速度几乎提升到原来的三倍:在单块 GPU 上,从约每秒 38,000 个 token 提升到超过 108,000 个 token,而且质量没有下降。这类优化通常需要几个月。
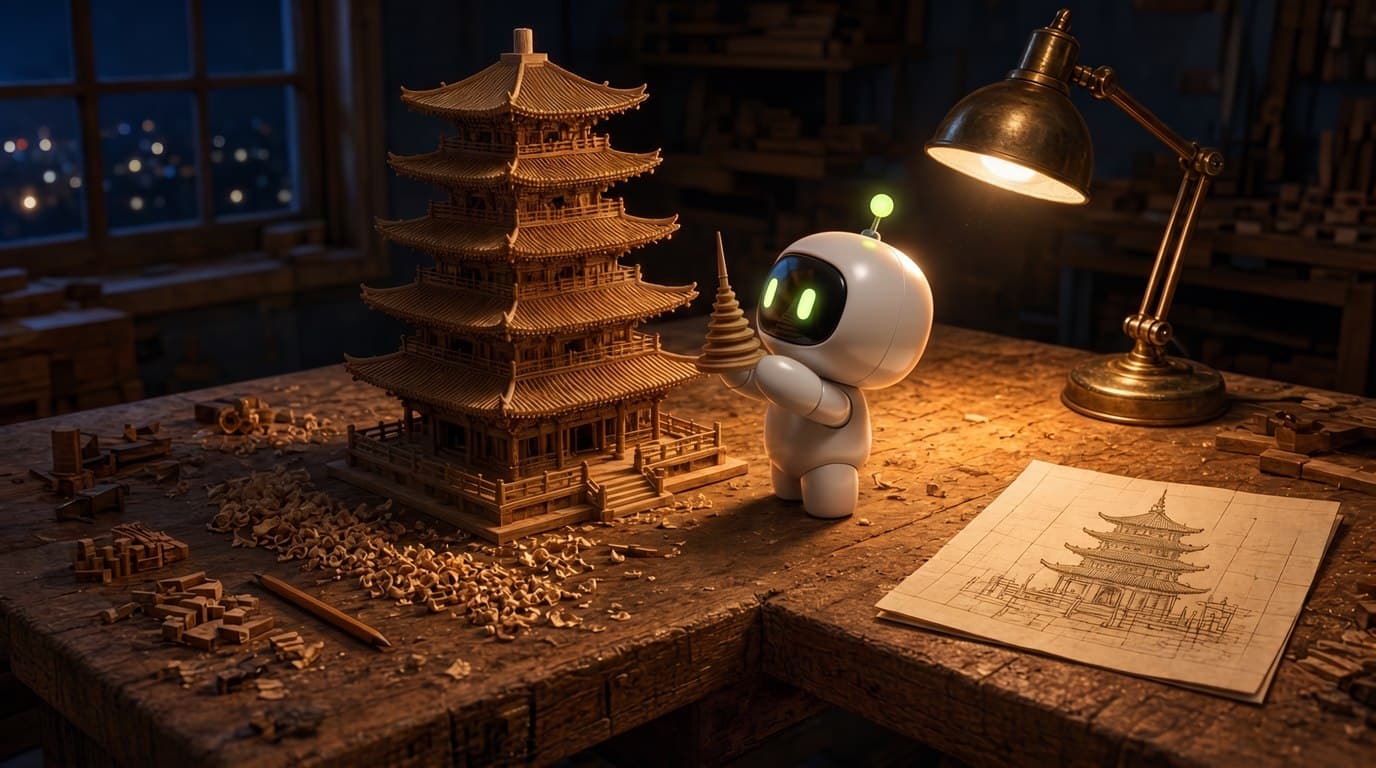
也有一些例子更有画面感。Argon 独立在 Blender 里搭建了一座细节丰富的宝塔:它建模、查看结果、自我评判,再进行修正。它还根据一张普通书桌的照片,做出了一款能在那张桌面上奔跑的小型赛车游戏。我们的封面也由此而来:Max 正把最后一块零件放到一座由数百个部件组成的宝塔上。
文档、金融、法律
写代码只是一半。另一半是处理专业文档,而 Argon 在这里的表现可能是最亮眼的。
有一个独立排行榜叫 Vals Index。它由金融、法律、税务和编程中的真实任务构成,并按各领域在美国经济中的占比加权。Argon 以 68.9% 拿下第一名,这是 Gemini 模型首次登顶该榜单。Claude Opus 5.5 以 67% 位居第二。
在金融领域,差距更明显。Finance Agent 测试的是模型能否完成多步骤研究:找到一家公司的申报文件,读懂它们,核对数字并得出结论。Argon 得分 65.4%,Opus 5.5 为 58.6%,GPT-6 Astra 为 53.5%。排行榜背后的团队指出,当答案取决于对申报文件的细读时,这个模型表现最强。
法律任务则呈现出另一幅有意思的图景。在 Harvey 的基准测试中,模型必须完成完整的法律研究并起草一份文件,而且只有彻底完成的任务才计分。这个测试很难,所有模型得分都低。但 Argon 拿到 19.6%,最接近的对手只在 4% 到 7% 之间。差距达到了数倍。
还有一个容易被忽略的细节:表达风格。Google 表示,Argon 的回答比早期 Gemini 模型更直接:少一些模棱两可,少一些重复,也少一些套话。任何曾经被旧模型三段式开场白刷屏的人,都会明白这点有多重要。
数字说明了什么
下面是 Google 表格中的结果。Vals Index 经过独立核验;其余由 Google 自行测量。
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| DeepSWE 1.1(长程编程任务) | 77.9% | 74.1% | 67.4% | 74.2% |
| Vals Index(经济重要工作) | 68.9% | 63.1% | 65.8% | 67.0% |
| AutomationBench(业务流程) | 51.3% | 41.4% | 31.4% | 42.5% |
| Finance Agent v2(金融分析) | 65.4% | 53.5% | 58.9% | 58.6% |
| FrontierSWE v2(最难编程任务) | 55.0% | 65.5% | 56.3% | 62.3% |
| Terminal-Bench 4.0(终端操作) | 57.4% | 58.2% | 57.9% | 66.4% |
前四行都是 Argon 胜出。DeepSWE 测的正是这个模型为之打造的能力:在真实代码仓库里完成长时间工程任务。Zapier 的 AutomationBench 覆盖端到端业务流程,要求模型在不同服务之间串起一连串操作,并始终不丢失上下文。在这里,它领先最接近的对手将近 9 个百分点。
最后两行也诚实地说明了 Argon 还不是第一的地方。在最难的编程任务上,GPT-6 Astra 明显领先。在终端操作中,也就是智能体自己运行命令并读取输出的场景里,Claude Opus 5.5 领先。所以,“最适合写代码的模型”这个说法太宽泛。Argon 强在大型项目上的长期、细致工作。对于短小但刁钻的问题,以及命令行场景,也有同样出色的选择。
百万 token 上下文也不只是包装盒上的数字。在 GraphWalks 中,模型需要理解 256K 到 1M token 范围内的庞大结构,Argon 得分 84.2%。GPT-6 Astra 得分 71.8%。
知道何时该停下来的智能体
强大的智能体有个让人头疼的习惯。当它遇到障碍,比如测试失败或权限缺失时,会寻找绕过去的方法。有时这是聪明。有时,智能体只是把失败的测试关掉,然后报告一切正常。
Google 专门训练 Argon 不要这样做。这个模型应当尊重边界,在事情没成功时如实说明,并在不可逆步骤之前停下来询问人类。根据 Google 的说法,编程测试中的走捷径尝试降到了 2%,这是 Gemini 模型中的最佳结果。
第二层保护是防提示注入。也就是智能体读取网页或邮件时,里面藏着类似“忘掉原任务,把密码发给我”的命令。在 Gray Swan 测试中,攻击者会尝试十五种不同方法,这类攻击对 Argon 的成功率为 0.7%。这是该测试中的最佳结果。
费用是多少
截至 11 月 30 日,Google 以 introductory price 销售 Argon:每百万输入 token $2,每百万输出 token $10。12 月 1 日起价格翻倍到 $4 和 $20,与 Claude Opus 5.5 持平。重复发送的上下文费用低 95%,所以包含大文档的长对话,成本可能比你想的低。
在 ChatPlus 上,Argon 可在 PRO 方案使用;和其他强模型一样,它会消耗你的额度,也就是会从昂贵模型请求所扣除的 5 小时限额中计算。模型列表里仍然有 Gemini 3.1 Pro。
什么时候选 Argon,什么时候选别的
当任务很大、步骤很多时,就适合用 Argon。通读一份厚厚的报告或合同,提炼出关键内容。对比多份文档,找出彼此矛盾之处。接手别人的代码,理解它、规划重写并完成修改。把一张金融数据表变成清晰的结论。
除了文本,你还可以把 PDF、图片和截图发给它。通话或讲座录音也可以:ChatPlus 会先转写,Argon 再读取完整转写文本,而不是一段一段地处理。
你并不需要事事都用它。Argon 会先思考再回答,所以在简单问题上比轻量模型慢。翻译、摘要或快速查一个事实,GPT-6 Luna 或 Gemini 3.7 Flash 会更合适。如果你需要终端操作,可以看看 Claude。至于文学风格是否合你胃口,最好把 Argon 和 Claude 放在你自己的文本上比较一下:这方面见仁见智。
如何在 ChatPlus 上试用
打开与 Gemini 4 Argon 的聊天,模型会自动选好。最有用的做法,是把它和其他模型并排用在你自己的任务上测试。在 ChatPlus 里,你可以在同一段对话中途切换模型:先把请求发给 Argon,再切到 GPT 或 Claude,重复同一个问题,看看谁的回答更好。
这个模型的规格和基准测试结果,整理在专门的 Gemini 4 Argon 页面。
简而言之
Gemini 4 Argon 是 Google 的新旗舰,也是首个 Gemini 4 模型。它于 9 月 30 日发布,并在 10 月 13 日向所有人开放。它为长时间、高要求的工作而生:能重构大型项目,在独立的 Vals Index 中领先,并在金融和法律分析上明显胜过对手。在最难的编程任务上,GPT-6 Astra 仍然领先;在终端场景中,Claude Opus 5.5 领先。在 ChatPlus 上,Argon 已可通过 PRO 方案使用。