H3 Max, Wan 3.0, dan GPT Image 2.5: satu genangan, lima model video
ChatPlus menambahkan dua model video, H3 Max yang supercepat dan Wan 3.0 yang terasa nyata, sementara GPT Image 2.5 menggantikan GPT Image 2. Kami memberi kelima model video prompt yang sama lalu menghitung waktunya: dari sebelas detik sampai hampir empat menit. Begini hasil masing-masing dan biayanya.
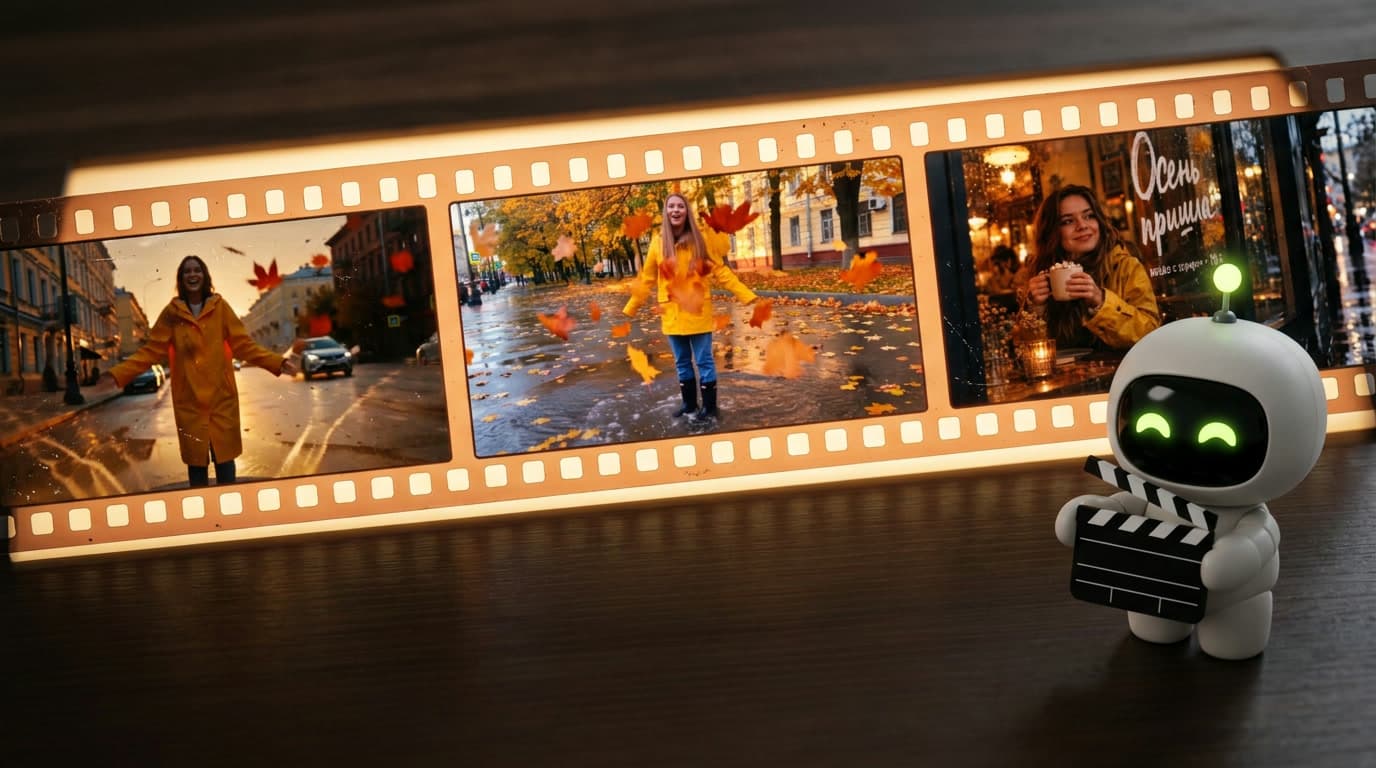
Membandingkan model video dari posting peluncurannya tidak akan membawa Anda ke mana-mana: semuanya mengaku "paling realistis" dan "terbaik di kelasnya". Jadi kami melakukan hal yang lebih sederhana. Kami mengambil satu prompt, mengirimkannya ke kelima model video di ChatPlus, lalu menghitung berapa lama masing-masing bekerja dan seperti apa hasilnya.
Prompt-nya: "Jalanan musim gugur setelah hujan, golden hour. Seorang perempuan muda berjas hujan kuning melompat ke genangan air, air terciprat, daun maple berputar di sekelilingnya. Ia tertawa dan berkata: 'Autumn is here!' Kamera handheld, suara jalanan natural."
Dua dari lima model itu baru di ChatPlus: H3 Max dan Wan 3.0. Kami juga memperbarui model gambar default, jadi GPT Image 2.5 kini berjalan di tempat yang sebelumnya diisi GPT Image 2. Mari kita bahas satu per satu, lalu di bagian akhir: kapan sebaiknya memilih yang mana.
H3 Max: klip selesai sebelum kopi Anda dingin
Mulai dari angka yang membuat model ini layak dicoba. Sebelas detik. Itulah waktu dari menekan tombol sampai klip lima detik dengan suara selesai, termasuk antrean dan pengunduhan file. Proses generasinya sendiri hanya memakan beberapa detik di GPU. Untuk prompt yang sama, model lain butuh waktu mulai dari sedikit di bawah satu menit sampai hampir empat menit.
Dari mana kecepatannya datang: basisnya adalah MiniMax H3, model video open-weights dari perusahaan Tiongkok MiniMax. Tim di fal, salah satu platform terbesar untuk menjalankan model generatif, melakukan post-training dan membangunnya ulang untuk server mereka sendiri. Mereka merilis hasilnya sebagai H3 Max pada akhir Agustus. Menurut pengukuran mereka, throughput naik sekitar 35 kali dibanding H3 asli, dan dalam perbandingan buta, ketika penonton memilih klip yang lebih baik dari dua klip tanpa tahu model mana yang membuatnya, H3 Max mengalahkan selusin pesaing.
Kecepatan bukan satu-satunya kelebihan. H3 Max selalu menghasilkan suara: bising jalan, langkah kaki, tawa, kalimat dialog pendek. Dalam pengujian kami, perempuan itu melompat ke genangan, daun-daun berputar di sekelilingnya, dan kalimat dari prompt terdengar jelas. Tidak ada tombol suara, dan memang tidak perlu, karena audio tidak menambah biaya.
H3 Max, 11 detik dari permintaan sampai file. Nyalakan suara untuk mendengar kalimat di akhir.
Sekarang batasannya secara jujur. Resolusinya 768p, di bawah Full HD. Itu sudah cukup untuk stories, reels, dan draft, tetapi bukan untuk layar besar. Dan pada adegan kompleks dengan gerakan cepat, H3 Max lebih sederhana dibanding model mahal: detailnya sedikit lebih lembut dan fisika airnya lebih terbatas.
Harganya menebus itu: 40 media credits per detik, jadi klip lima detik menghabiskan 200 credits. Ini video termurah di ChatPlus. Cara kami memakainya: coba lima atau sepuluh versi prompt, temukan ide yang paling berhasil, lalu kalau mau, kirim versi finalnya ke model yang lebih mahal.
Wan 3.0: video yang terlihat seperti direkam pakai ponsel
Wan adalah keluarga model video dari Alibaba. Generasi ketiganya masuk beta pada awal Agustus 2026 dan tersedia untuk semua orang pada 24 Agustus. Fokus Alibaba adalah manusia: wajah beragam yang tampak hidup, ekspresi natural, gerakan tanpa kesan plastik yang sering muncul di banyak model AI.
Model ini bisa melakukan lebih dari yang kami pakai hari ini. Secara native, ia menghasilkan klip hingga 30 detik dan menerima teks, gambar, audio, bahkan video sebagai input. Di ChatPlus Anda bisa membuat klip 5, 10, atau 15 detik dalam 720p, dari deskripsi atau dari foto Anda sendiri.
Dalam pengujian kami, Wan membuat klip yang paling terasa sehari-hari dari kelimanya. Tidak ada kilap iklan: jalan biasa, sepatu bot karet, daun beterbangan langsung ke arah lensa. Hasilnya paling mirip video yang direkam teman dengan ponselnya, persis seperti yang diminta oleh "kamera handheld". Suara dan kalimat yang diucapkan sama-sama ada.
Wan 3.0, 2 menit 37 detik. Footage yang paling terasa seperti rekaman ponsel dari kelimanya.
Kami menunggu lebih dari dua setengah menit. Itu normal untuk model video di level ini, tetapi setelah H3 Max rasanya lama sekali.
Dari sisi harga, Wan 3.0 berada di tengah: 50 media credits per detik, dan suara tidak mengubah biaya. Klip lima detik menghabiskan 250 credits. Kling 3 Pro dengan suara biayanya 420, dan Seedance Pro 760. Kalau Anda butuh orang di layar yang terlihat meyakinkan tanpa membayar terlalu mahal, mulai dari Wan.
Satu prompt, lima model
Begini hasil kelimanya. Waktu dihitung dari permintaan sampai file jadi, harga untuk klip sepanjang itu dengan suara.
| Model | Waktu | Durasi | Harga, credits |
|---|---|---|---|
| H3 Max | 11 dtk | 5 dtk | 200 |
| Veo 3.1 | 54 dtk | 6 dtk | 1,200 (Fast: 456) |
| Kling 3 Pro | 1 mnt 46 dtk | 5 dtk | 420 |
| Wan 3.0 | 2 mnt 37 dtk | 5 dtk | 250 |
| Seedance Pro | 3 mnt 54 dtk | 5 dtk | 760 |
Veo 3.1 dari Google menghasilkan shot paling sinematik: matahari langsung ke lensa, hamparan daun merah di tepi jalan, cipratan besar, semuanya seperti keluar dari iklan. Suara Veo adalah yang terbaik di antara semuanya, soundtrack yang tercampur rapi, bukan sekadar noise yang ditumpuk di atas gambar. Ini juga detik termahal di ChatPlus. Untuk draft ada Veo 3.1 Fast: lebih cepat dan jauh lebih murah.
Veo 3.1, 54 detik. Backlight dan warna seperti iklan.
Kling 3 Pro memilih pendekatannya sendiri. Sepanjang klip, kamera tetap fokus pada kaki dan cipratannya; kami mendengar kalimatnya tetapi tidak pernah melihat wajahnya. Modelnya tidak salah, hanya membaca "melompat ke genangan" secara harfiah. Kekuatan utama Kling ada di tempat lain, yaitu menghidupkan foto, selengkapnya di bawah.
Kling 3 Pro, 1 menit 46 detik. Sepatu bot, cipratan, dan pantulan, tetapi tanpa wajah.
Seedance Pro dari ByteDance memakan waktu paling lama dan menunjukkan penanganan gerakan yang paling teliti. Lembaran air bersih yang terangkat dari genangan, daun tertangkap di udara, dan kamera yang bergerak dari wide shot sampai sangat dekat ke wajahnya yang tertawa, seolah ada operator kamera berlari di sampingnya.
Seedance Pro, 3 menit 54 detik. Dari wide shot ke close-up dalam satu take.
Kesimpulannya: tidak ada satu model yang mutlak "terbaik". Masing-masing punya karakter sendiri, dan pilihan yang tepat bergantung pada pekerjaannya.
GPT Image 2.5 menggantikan GPT Image 2
Sekarang gambar. Pada 8 September, OpenAI merilis GPT Image 2.5 dalam dua versi. Sunburst adalah versi yang presisi: lebih patuh pada prompt dan lebih baik saat mengedit gambar yang sudah ada. Flare adalah versi yang lebih cepat dan sederhana. ChatPlus menjalankan Sunburst.
GPT Image 2 sudah menjadi default kami karena sangat bagus menangani teks di dalam gambar. Versi 2.5 bahkan lebih rapi untuk lettering dan lebih mampu mempertahankan prompt panjang yang penuh detail. Kami mengujinya dengan tema musim gugur yang sama: perempuan berjas hujan kuning di meja kafe dengan secangkir cokelat, plus teks tulisan tangan di jendela. Sedikit lebih dari setengah menit kemudian, gambarnya jadi, dengan judul bergaya tulisan tangan di kaca dan baris harga kecil di bawahnya, tanpa satu huruf pun yang rusak. Ia bahkan menambahkan papan menu di belakang atas inisiatif sendiri, dan hasilnya juga bersih.
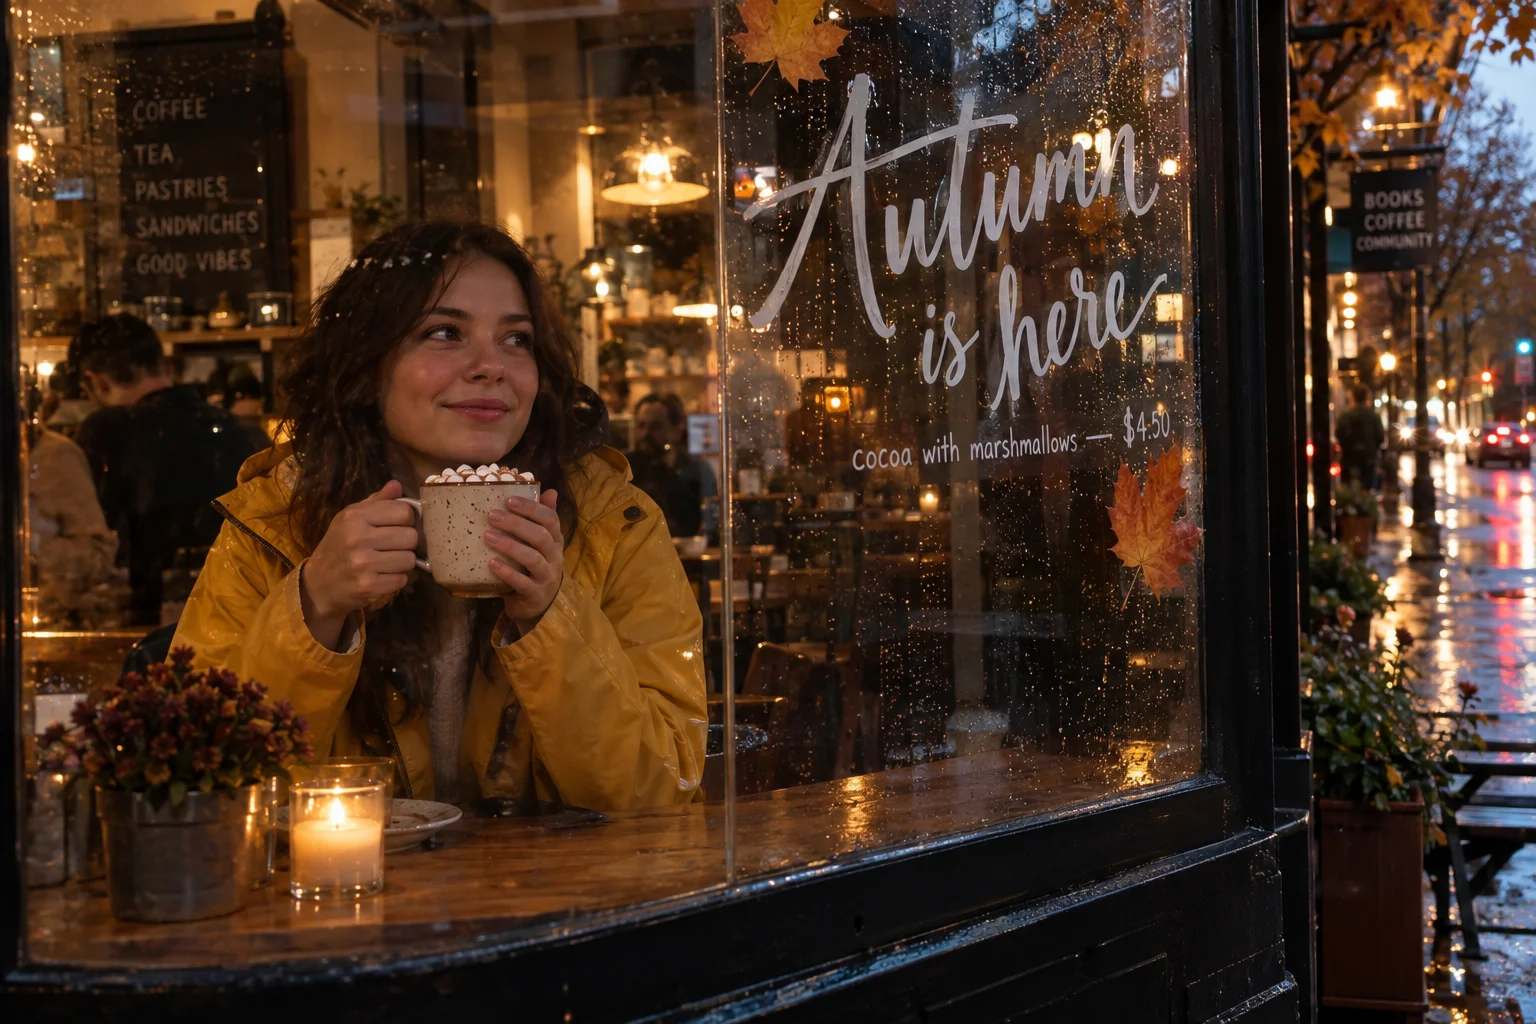
GPT Image 2.5, 36 detik. Kedua baris di kaca langsung benar sejak percobaan pertama.
Edit juga lebih andal. Unggah foto lalu sebutkan apa yang ingin diubah: model mengubah bagian yang Anda minta dan lebih kecil kemungkinannya menggambar ulang hal lain.
Harga tidak berubah: 10 media credits per gambar untuk kualitas standar dan 50 untuk kualitas tinggi. Kalau sebelumnya Anda memilih GPT Image 2, tidak ada yang perlu dilakukan: generator sudah otomatis beralih ke 2.5. Coba GPT Image 2.5.
Gambar dulu, lalu video
Hasil paling menarik dari pengujian ini terjadi tanpa sengaja. Kami mengambil gambar kafe dari GPT Image 2.5 tadi dan memberikannya ke Kling 3 Pro untuk dianimasikan. Uap naik dari cokelat, tetes air mengalir di kaca, perempuan itu tersenyum. Dan tulisan di jendela tidak melengkung di satu frame pun, padahal teks biasanya hal pertama yang rusak di model video.
Gambar oleh GPT Image 2.5, gerakan oleh Kling 3 Pro.
Ini memberi Anda resep yang andal untuk cover, kartu, dan klip sosial. Pertama gambar frame sempurna di GPT Image 2.5: murah, dan teksnya benar. Lalu hidupkan dengan Kling 3 Pro atau Wan 3.0. Ini jauh lebih mudah diprediksi daripada mendeskripsikan seluruh adegan dengan kata-kata dan berharap model video menyusun semuanya dengan benar.
Satu catatan. Seedance Pro tidak akan menganimasikan foto orang asli, karena ByteDance memblokirnya. Untuk potret dan foto keluarga, gunakan Kling 3 Pro: wajah tetap dapat dikenali dari detik pertama sampai terakhir.
Model mana yang sebaiknya dipilih
Singkatnya, tergantung pekerjaannya.
Cepat dan murah — menguji ide, membuat story, mencoba variasi prompt — H3 Max. Sekitar sepuluh detik dan 200 credits per percobaan.
Orang yang tampak nyata dalam shot sehari-hari yang tidak terasa seperti iklan — Wan 3.0. Suara termasuk, harga kelas menengah.
Menghidupkan foto Anda sendiri — Kling 3 Pro. Wajah, pakaian, dan tulisan tetap seperti di shot awal.
Klip sinematik dengan suara kualitas film — Veo 3.1, dan Veo 3.1 Fast untuk draft.
Gerakan kompleks — tari, olahraga, air, pergantian shot — Seedance Pro, kalau Anda tidak keberatan menunggu dan membayar lebih.
Anda bisa mengganti model langsung di generator video, misalnya mulai dengan H3 Max. Video dan gambar memakai media credits yang sama, dan harga klip ditampilkan sebelum Anda mulai.
Singkatnya
ChatPlus punya dua model video baru. H3 Max adalah versi MiniMax H3 yang dipercepat oleh fal: klip dengan suara dalam sekitar sepuluh detik, 200 media credits untuk lima detik, 768p. Wan 3.0 dari Alibaba menghadirkan orang yang tampak hidup dan gerakan natural, dengan suara termasuk dalam harga, 250 credits untuk lima detik. Model gambar default kini GPT Image 2.5 dari OpenAI: lebih rapi untuk teks dan edit, dengan harga yang sama, 10 dan 50 credits. Dalam pengujian satu prompt kami, H3 Max adalah yang tercepat, Veo 3.1 paling sinematik, dan Seedance Pro paling teliti menangani gerakan.