H3 Max、Wan 3.0 和 GPT Image 2.5:同一个水坑,五款视频模型
ChatPlus 新增两款视频模型:快如闪电的 H3 Max,以及更贴近真实影像的 Wan 3.0;GPT Image 2.5 也已取代 GPT Image 2。我们给五款视频模型都用了同一段提示词并计时:从 11 秒到将近 4 分钟。下面看看它们各自的表现和费用。
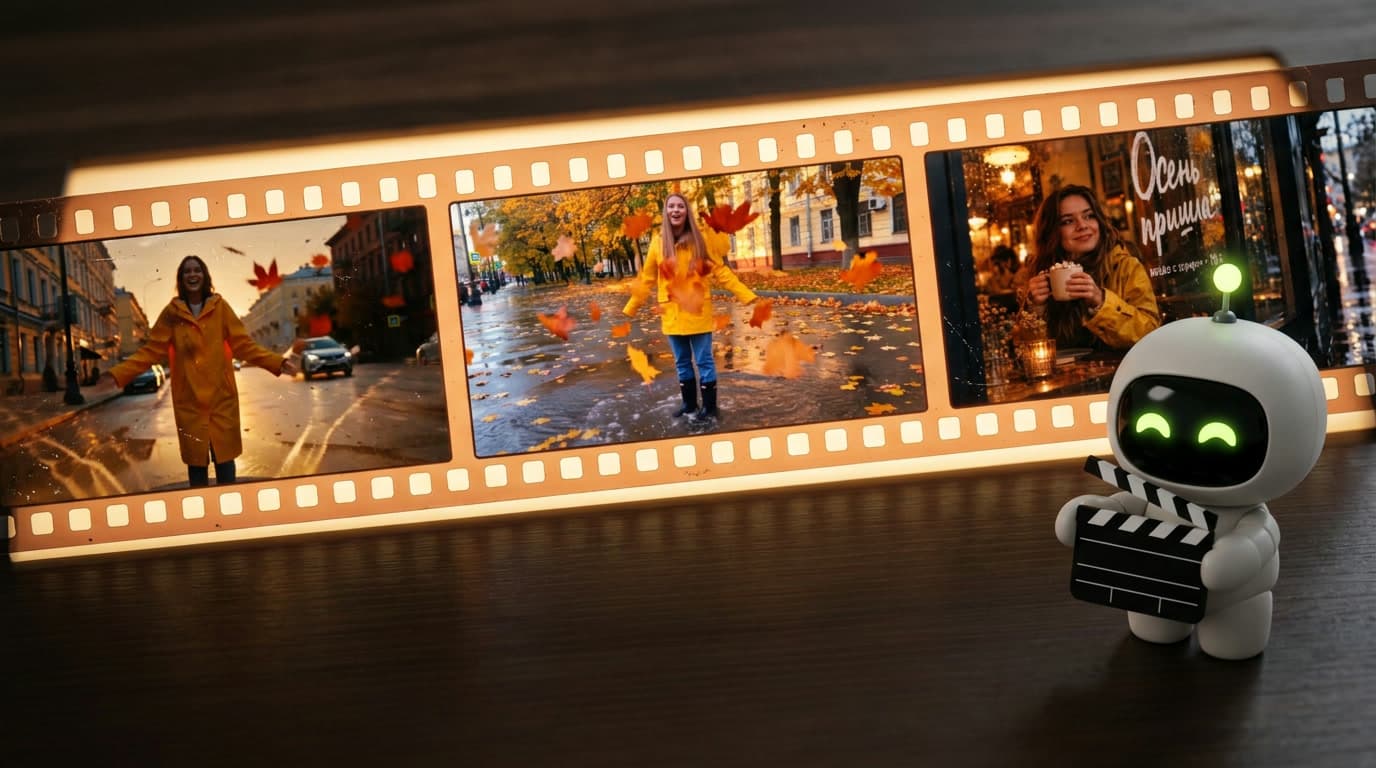
只看视频模型的发布稿来比较,基本看不出所以然:每一个都号称自己“最真实”“同类最佳”。所以我们用了一个更简单的办法。我们拿同一段提示词,发给 ChatPlus 上的五款视频模型,记录每个模型花了多久,以及最终生成了什么。
提示词是:“An autumn street after the rain, golden hour. A young woman in a yellow raincoat jumps into a puddle, water splashes, maple leaves swirl around her. She laughs and says: 'Autumn is here!' Handheld camera, natural street sound.”
五款模型里有两款是 ChatPlus 新加入的:H3 Max 和 Wan 3.0。我们也更新了默认图像模型,现在 GPT Image 2.5 已经接替 GPT Image 2。下面逐一看看它们的表现,最后再说什么场景该选哪一个。
H3 Max:咖啡还没凉,短片已经好了
先看最让人想试试这个模型的数字。11 秒。 从按下按钮,到拿到一条带声音的 5 秒成片,包括排队和文件下载,总共就是这么久。真正跑在 GPU 上生成,只用了几秒。同一段提示词,其他模型少则接近一分钟,多则将近四分钟。
速度从何而来:它的底座是 MiniMax H3,这是中国公司 MiniMax 推出的开源权重视频模型。fal 团队——也就是最大的生成式模型运行平台之一——对它做了后训练,并为自家服务器重新改造。他们在 8 月底发布了 H3 Max。按他们的测算,吞吐量相比原版 H3 提升了大约 35 倍;在盲测对比中,也就是让观众在不知道哪条片子由哪个模型生成的情况下二选一,H3 Max 击败了十几位竞争对手。
速度不是唯一优点。H3 Max 总是会生成声音:街道环境声、脚步声、笑声、简短对白。我们的测试里,女子跳进水坑,树叶在身边旋转,提示词里的那句台词也清楚地说了出来。这里没有声音开关,也不需要,因为音频不额外收费。
H3 Max,从请求到文件用时 11 秒。记得打开声音,听最后那句台词。
再说清楚它的限制。分辨率是 768p,低于 Full HD。用来做 stories、reels 和草稿完全够了,但不适合大屏播放。而在高速运动的复杂场景里,H3 Max 比昂贵模型要简单一些:细节会稍微软一点,水花的物理效果也更克制。
价格把这些都补回来了:每秒 40 个媒体积分,所以一条 5 秒短片是 200 个积分。这是 ChatPlus 上最便宜的视频。我们的用法是:先用它给同一段提示词跑五版、十版,找到可行的创意;如果需要,再把最终版本交给更贵的模型生成。
Wan 3.0:像手机随手拍出来的视频
Wan 是 Alibaba 的视频模型家族。第三代在 2026 年 8 月初进入 beta,并于 8 月 24 日面向所有人开放。Alibaba 的重点放在人身上:各种类型的面孔都更像真人,表情自然,动作也没有很多 AI 模型常见的塑料感。
这个模型的能力比我们今天用到的更多。它原生可生成最长 30 秒的片段,输入可以是文字、图片、音频,甚至视频。在 ChatPlus 上,你可以用文字描述或自己的照片生成 720p 的 5 秒、10 秒或 15 秒短片。
在我们的测试中,Wan 做出了五款里最有日常感的一条。没有广告片式的光鲜滤镜:普通街道、雨靴、树叶直直飞向镜头。它最像朋友用手机随手拍的一段视频,而这正是“handheld camera”要的效果。声音和那句台词也都在。
Wan 3.0,2 分 37 秒。五条里最像手机拍摄的一条。
我们等了两分半多。对这个级别的视频模型来说很正常,但刚看完 H3 Max 之后,会觉得格外漫长。
价格方面,Wan 3.0 位于中档:每秒 50 个媒体积分,声音不会改变费用。5 秒短片是 250 个积分。带声音的 Kling 3 Pro 要 420,Seedance Pro 要 760。如果你需要屏幕上出现一个可信的人物,同时不想花太多,可以从 Wan 开始。
同一段提示词,五款模型
五款模型的表现如下。时间是从发出请求到拿到成片文件,价格是一条对应时长、带声音的短片所需积分。
| Model | Time | Length | Price, credits |
|---|---|---|---|
| H3 Max | 11 s | 5 s | 200 |
| Veo 3.1 | 54 s | 6 s | 1,200 (Fast: 456) |
| Kling 3 Pro | 1 min 46 s | 5 s | 420 |
| Wan 3.0 | 2 min 37 s | 5 s | 250 |
| Seedance Pro | 3 min 54 s | 5 s | 760 |
Google 的 Veo 3.1 交出了最有电影感的一条:阳光直射镜头,路边铺满红色落叶,水花溅起很大,整个画面像从广告片里截出来。Veo 的声音也是这一组里最好的,它更像一条混好的声轨,而不是在画面上叠一层噪音。它同时也是 ChatPlus 上每秒费用最高的模型。做草稿可以用 Veo 3.1 Fast:更快,也便宜得多。
Veo 3.1,54 秒。逆光和色彩都像广告片。
Kling 3 Pro 走了自己的路线。整条片子里,镜头一直盯着她的脚和水花;我们听到了那句台词,却始终没看到她的脸。模型不算做错,只是把“jumps into a puddle”理解得非常字面。Kling 真正的强项在别处:让照片动起来。下面会说到。
Kling 3 Pro,1 分 46 秒。有靴子、水花和倒影,但没有脸。
ByteDance 的 Seedance Pro 用时最长,但对动作的处理也最细致。水从水坑里成片飞起,树叶定格在半空中,镜头从广角一路推进到她大笑的脸,像是有摄影师跟着她一起跑。
Seedance Pro,3 分 54 秒。一个镜头里从远景推进到特写。
结论是:没有单一的“最佳”模型。每个模型都有自己的性格,选哪个要看你要做什么。
GPT Image 2.5 取代 GPT Image 2
再来看图像。9 月 8 日,OpenAI 发布了两个版本的 GPT Image 2.5。Sunburst 是更精准的版本:更能贴合提示词,也更擅长编辑已有图片。Flare 则更快、更简单。ChatPlus 使用的是 Sunburst。
GPT Image 2 已经是我们的默认模型,因为它非常擅长在图片里生成文字。2.5 版本的字形更整洁,也更能稳住信息量很大的长提示词。我们用同样的秋日主题做了测试:穿黄色雨衣的女子坐在咖啡馆桌边,面前是一杯可可,窗上还有手写字。半分多钟后,图片生成好了:玻璃上有一行手写标题,下方还有一行小小的价格说明,一个坏字母都没有。它甚至自己在后面加了一块菜单板,文字也很干净。
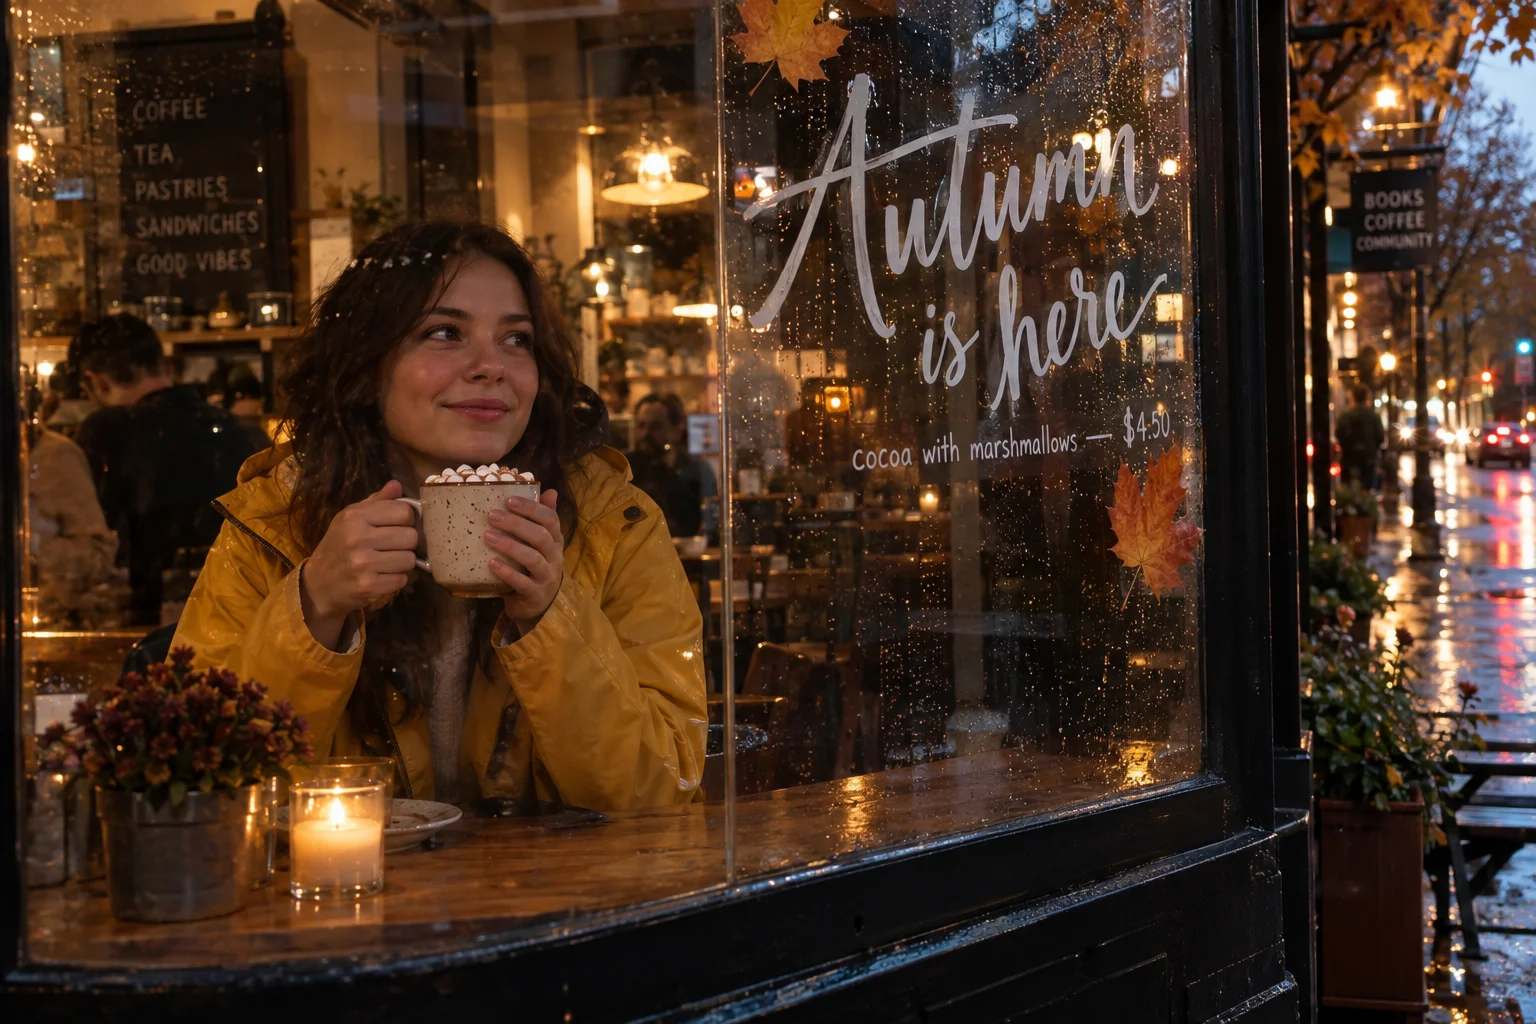
GPT Image 2.5,36 秒。玻璃上的两行字第一次就对了。
编辑也更可靠了。上传一张照片,说出要改哪里:模型会改你指定的部分,也更少把其他地方重画掉。
价格不变:标准质量每张 10 个媒体积分,高质量每张 50 个。如果你原本选的是 GPT Image 2,不需要做任何操作:生成器已经自动切换到 2.5。试试 GPT Image 2.5。
先做图,再做视频
这次测试里最有意思的结果,其实是偶然发现的。我们把 GPT Image 2.5 生成的那张咖啡馆图片交给 Kling 3 Pro 做动画。可可升起热气,雨滴沿着玻璃往下流,女子抬头微笑。而窗上的字,在每一帧里都没有变形;通常文字可是视频模型最容易搞坏的部分。
图片由 GPT Image 2.5 生成,动态由 Kling 3 Pro 完成。
这给封面、贺卡和社交短片提供了一个很稳的流程。先用 GPT Image 2.5 画出完美的一帧:便宜,而且文字正确。然后再用 Kling 3 Pro 或 Wan 3.0 让它动起来。相比用文字描述整个场景、期待视频模型把所有元素都摆对,这种方式可预测得多。
有一点要注意。Seedance Pro 不会为真人照片做动画,因为 ByteDance 会阻止这类处理。做人像和家庭照片,可以用 Kling 3 Pro:从第一秒到最后一秒,它都能保持脸部可识别。
该选哪个模型
简单说,看任务。
又快又便宜——测试创意、做 story、尝试不同提示词——选 H3 Max。每次大约 10 秒,200 个积分。
日常、非广告感镜头里的真实人物——选 Wan 3.0。包含声音,价格中档。
让自己的照片动起来——选 Kling 3 Pro。脸、衣服和文字都能尽量保持原样。
电影感短片,还要电影级声音——选 Veo 3.1;草稿用 Veo 3.1 Fast。
复杂动作——舞蹈、运动、水、镜头切换——选 Seedance Pro,前提是你愿意等,也愿意多花一些。
你可以直接在视频生成器里切换模型,比如从 H3 Max 开始。视频和图像使用同一套媒体积分,开始生成前会显示这条片子的价格。
简而言之
ChatPlus 新增了两款视频模型。H3 Max 是 fal 对 MiniMax H3 的加速版本:约 10 秒生成带声音短片,5 秒 200 个媒体积分,768p。Alibaba 的 Wan 3.0 带来更像真人的人物和自然动作,声音包含在价格里,5 秒 250 个积分。默认图像模型现在是 OpenAI 的 GPT Image 2.5:文字和编辑更干净,价格仍是 10 和 50 个积分。在我们这次同一提示词测试中,H3 Max 最快,Veo 3.1 最有电影感,Seedance Pro 对动作处理最细致。