H3 Max, Wan 3.0 i GPT Image 2.5: jedna kałuża, pięć modeli wideo
ChatPlus dodaje dwa modele wideo: błyskawiczny H3 Max i realistyczny Wan 3.0, a GPT Image 2.5 zastępuje GPT Image 2. Daliśmy wszystkim pięciu modelom wideo ten sam prompt i zmierzyliśmy czas: od jedenastu sekund do prawie czterech minut. Oto jak wypadł każdy z nich i ile to kosztuje.
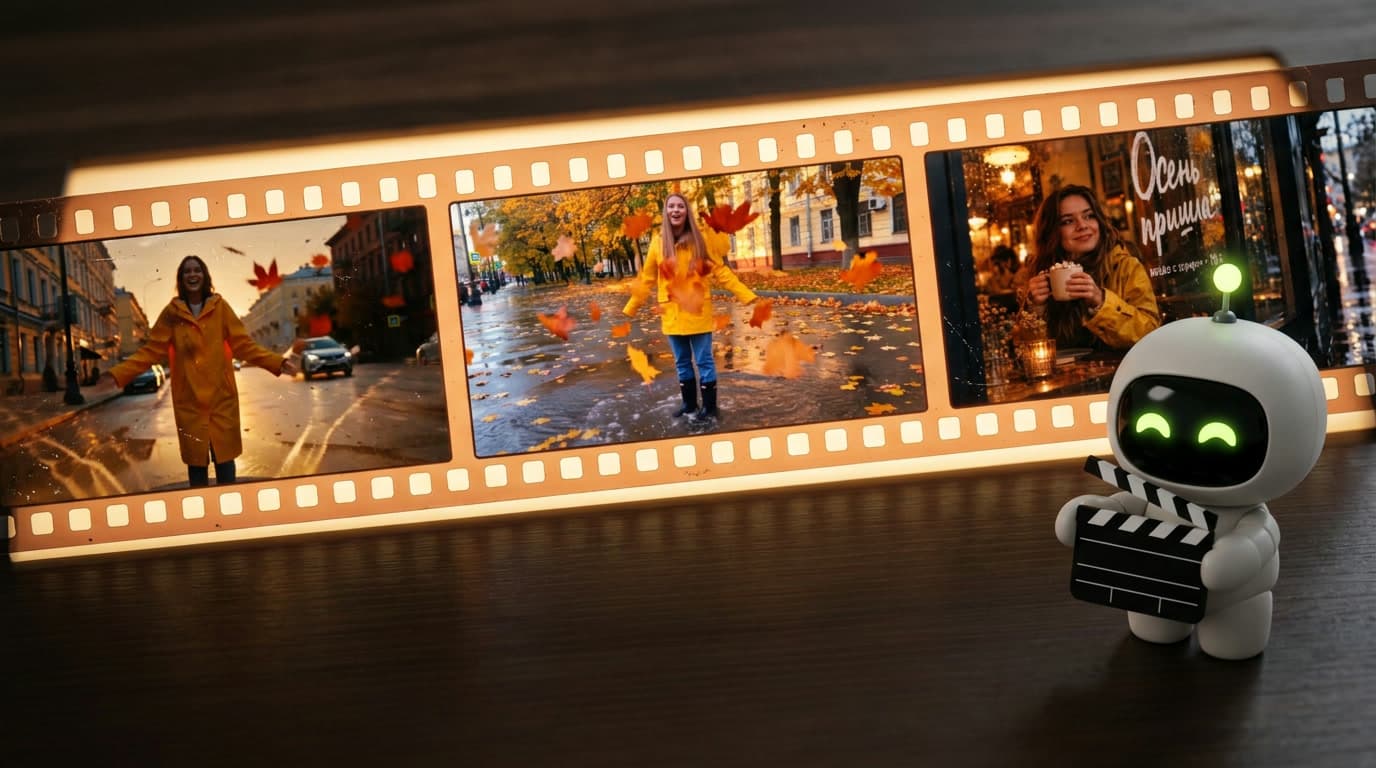
Porównywanie modeli wideo po wpisach premierowych prowadzi donikąd: każdy jest „najbardziej realistyczny” i „najlepszy w swojej klasie”. Zrobiliśmy więc coś prostszego. Wzięliśmy jeden prompt, wysłaliśmy go do wszystkich pięciu modeli wideo w ChatPlus i zmierzyliśmy, ile trwa generowanie oraz co wraca na końcu.
Prompt: „Jesienna ulica po deszczu, złota godzina. Młoda kobieta w żółtym płaszczu przeciwdeszczowym wskakuje do kałuży, woda rozpryskuje się, wokół wirują liście klonu. Śmieje się i mówi: ‘Autumn is here!’ Kamera z ręki, naturalny dźwięk ulicy.”
Dwa z pięciu modeli są nowe w ChatPlus: H3 Max i Wan 3.0. Zaktualizowaliśmy też domyślny model obrazów, więc GPT Image 2.5 działa teraz tam, gdzie wcześniej był GPT Image 2. Przejdźmy po kolei przez każdy z nich, a na końcu: który wybrać do jakiego zadania.
H3 Max: klip gotowy, zanim kawa wystygnie
Zacznijmy od liczby, przez którą naprawdę warto dać temu modelowi szansę. Jedenaście sekund. Tyle minęło od naciśnięcia przycisku do gotowego pięciosekundowego klipu z dźwiękiem, razem z kolejką i pobraniem pliku. Samo generowanie na GPU trwa tylko kilka sekund. Pozostałe modele potrzebowały na ten sam prompt od niecałej minuty do prawie czterech minut.
Skąd ta prędkość: bazą jest MiniMax H3, model wideo z otwartymi wagami od chińskiej firmy MiniMax. Zespół fal, jednej z największych platform do uruchamiania modeli generatywnych, dotrenował go po fakcie i przebudował pod własne serwery. Efekt wypuścili jako H3 Max pod koniec sierpnia. Według ich pomiarów przepustowość wzrosła około 35 razy względem oryginalnego H3, a w ślepych porównaniach, w których widzowie wybierają lepszy z dwóch klipów, nie wiedząc, który model go zrobił, H3 Max pokonał tuzin konkurentów.
Szybkość to niejedyny plus. H3 Max zawsze generuje dźwięk: szum ulicy, kroki, śmiech, krótkie kwestie dialogowe. W naszym teście kobieta wskoczyła do kałuży, liście zakręciły się wokół niej, a kwestia z promptu zabrzmiała wyraźnie. Nie ma przełącznika dźwięku i nie musi go być, bo audio nic nie kosztuje dodatkowo.
H3 Max, 11 sekund od zapytania do pliku. Włącz dźwięk, żeby usłyszeć kwestię na końcu.
Teraz uczciwie o ograniczeniach. Rozdzielczość to 768p, czyli poniżej Full HD. Do stories, reelsów i szkiców wystarczy z nawiązką, ale nie na duży ekran. A w złożonych scenach z szybkim ruchem H3 Max jest prostszy niż droższe modele: detale są trochę miększe, a fizyka wody skromniejsza.
Ceną to nadrabia: 40 kredytów multimedialnych za sekundę, więc pięciosekundowy klip kosztuje 200 kredytów. To najtańsze wideo w ChatPlus. My używalibyśmy go tak: robisz pięć albo dziesięć wersji promptu, znajdujesz pomysł, który działa, a potem, jeśli chcesz, wysyłasz finalną wersję do droższego modelu.
Wan 3.0: wideo, które wygląda jak nagrane telefonem
Wan to rodzina modeli wideo od Alibaba. Trzecia generacja weszła w betę na początku sierpnia 2026 i stała się dostępna dla wszystkich 24 sierpnia. Alibaba skupiła się na ludziach: wiarygodnych twarzach różnego typu, naturalnej mimice i ruchu bez plastikowego efektu, który ma wiele modeli AI.
Model potrafi więcej, niż wykorzystujemy dziś. Natywnie generuje klipy do 30 sekund i przyjmuje jako wejście tekst, obrazy, audio, a nawet wideo. W ChatPlus możesz robić klipy 5-, 10- albo 15-sekundowe w 720p, z opisu albo z własnego zdjęcia.
W naszym teście Wan zrobił najbardziej codzienny klip z całej piątki. Bez reklamowego połysku: zwykła ulica, kalosze, liście lecące prosto w obiektyw. Najbardziej przypomina filmik, który koleżanka nagrała telefonem, czyli dokładnie to, o co prosiliśmy hasłem „kamera z ręki”. Dźwięk i wypowiedziana kwestia są na miejscu.
Wan 3.0, 2 minuty 37 sekund. Najbardziej „telefonowe” ujęcie z całej piątki.
Czekaliśmy ponad dwie i pół minuty. To normalne przy modelach wideo tej klasy, ale po H3 Max wydaje się wiecznością.
Cenowo Wan 3.0 siedzi pośrodku: 50 kredytów multimedialnych za sekundę, a dźwięk nie zmienia kosztu. Pięciosekundowy klip kosztuje 250 kredytów. Kling 3 Pro z dźwiękiem kosztuje 420, a Seedance Pro 760. Jeśli potrzebujesz wiarygodnej osoby na ekranie bez przepłacania, zacznij od Wan.
Jeden prompt, pięć modeli
Tak poradziła sobie cała piątka. Czas liczymy od zapytania do gotowego pliku, cena dotyczy klipu tej długości z dźwiękiem.
| Model | Czas | Długość | Cena, kredyty |
|---|---|---|---|
| H3 Max | 11 s | 5 s | 200 |
| Veo 3.1 | 54 s | 6 s | 1,200 (Fast: 456) |
| Kling 3 Pro | 1 min 46 s | 5 s | 420 |
| Wan 3.0 | 2 min 37 s | 5 s | 250 |
| Seedance Pro | 3 min 54 s | 5 s | 760 |
Veo 3.1 od Google dał najbardziej filmowe ujęcie: słońce prosto w obiektyw, dywan czerwonych liści przy krawężniku, duży rozbryzg — jak kadr z reklamy. Dźwięk w Veo jest najlepszy z całej grupy: to zmiksowana ścieżka, a nie hałas doklejony na wierzchu. To też najdroższa sekunda w ChatPlus. Do szkiców jest Veo 3.1 Fast: szybszy i dużo tańszy.
Veo 3.1, 54 sekundy. Kontra i kolor jak w reklamie.
Kling 3 Pro poszedł własną drogą. Przez cały klip kamera trzymała się jej stóp i rozbryzgów; słyszeliśmy kwestię, ale nigdy nie zobaczyliśmy twarzy. Model nie pomylił się, tylko przeczytał „wskakuje do kałuży” bardzo dosłownie. Prawdziwa siła Kling leży gdzie indziej: w ożywianiu zdjęć. Więcej o tym za chwilę.
Kling 3 Pro, 1 minuta 46 sekund. Kalosze, rozbryzgi i odbicia, ale bez twarzy.
Seedance Pro od ByteDance trwał najdłużej i najdokładniej potraktował ruch. Czyste płaty wody odrywające się od kałuży, liście zatrzymane w locie i kamera, która przechodzi od szerokiego planu aż do jej roześmianej twarzy, jakby operator biegł obok.
Seedance Pro, 3 minuty 54 sekundy. Od szerokiego planu do zbliżenia w jednym ujęciu.
Wniosek: nie ma jednego „najlepszego” modelu. Każdy ma własny charakter, a właściwy wybór zależy od zadania.
GPT Image 2.5 zastępuje GPT Image 2
Teraz obrazy. 8 września OpenAI wypuściło GPT Image 2.5 w dwóch wersjach. Sunburst to ta precyzyjna: dokładniej trzyma się promptu i lepiej edytuje istniejące grafiki. Flare jest szybsza i prostsza. ChatPlus uruchamia Sunburst.
GPT Image 2 już wcześniej był naszym modelem domyślnym, bo świetnie radzi sobie z tekstem w obrazach. Wersja 2.5 jeszcze schludniej robi liternictwo i lepiej utrzymuje długie prompty pełne szczegółów. Przetestowaliśmy go na tym samym jesiennym motywie: kobieta w żółtym płaszczu przeciwdeszczowym przy stoliku w kawiarni z kubkiem kakao, plus ręcznie pisany tekst na szybie. Po nieco ponad pół minuty mieliśmy obraz z odręcznym nagłówkiem na szkle i małą linijką z ceną pod spodem — bez ani jednej popsutej litery. Model sam dodał nawet tablicę z menu w tle i ona też wyszła czysto.
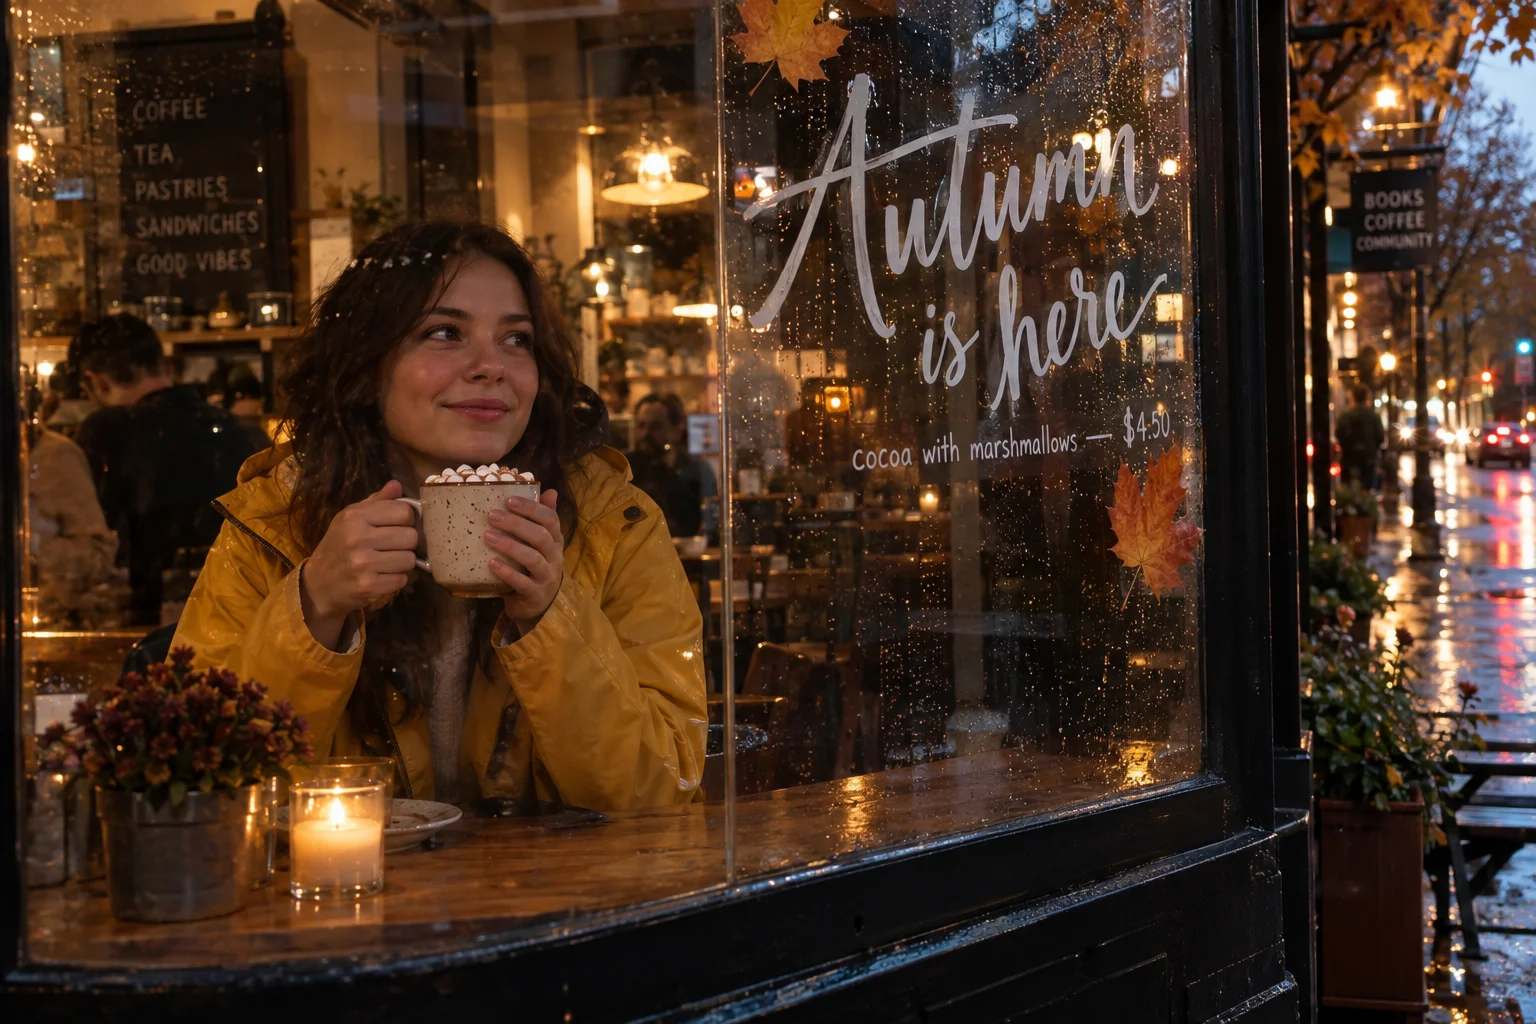
GPT Image 2.5, 36 sekund. Obie linijki na szybie wyszły poprawnie za pierwszym razem.
Edycje też są pewniejsze. Wgrywasz zdjęcie i mówisz, co zmienić: model zmienia to, o co prosisz, i rzadziej przerysowuje cokolwiek innego.
Ceny się nie zmieniły: 10 kredytów multimedialnych za obraz w jakości standardowej i 50 w wysokiej. Jeśli miałeś wybrany GPT Image 2, nie musisz nic robić: generator sam przełączył się na 2.5. Wypróbuj GPT Image 2.5.
Najpierw obraz, potem wideo
Najciekawszy wynik testu pojawił się przypadkiem. Wzięliśmy ten kawiarniany obraz z GPT Image 2.5 i daliśmy go do animacji w Kling 3 Pro. Para uniosła się znad kakao, krople spływały po szybie, kobieta się uśmiechnęła. A napis na oknie nie wykrzywił się ani w jednej klatce, choć tekst zwykle jest pierwszą rzeczą, którą modele wideo psują.
Obraz od GPT Image 2.5, ruch od Kling 3 Pro.
To daje sprawdzony przepis na okładki, kartki i klipy do sociali. Najpierw rysujesz idealny kadr w GPT Image 2.5: tanio i z poprawnym tekstem. Potem ożywiasz go w Kling 3 Pro albo Wan 3.0. To dużo bardziej przewidywalne niż opisywanie całej sceny słowami i liczenie, że model wideo wszystko poprawnie poukłada.
Jedno zastrzeżenie. Seedance Pro nie animuje zdjęć prawdziwych osób, bo ByteDance je blokuje. Do portretów i zdjęć rodzinnych użyj Kling 3 Pro: zachowuje rozpoznawalną twarz od pierwszej do ostatniej sekundy.
Który model wybrać
W skrócie: to zależy od zadania.
Szybko i tanio — testowanie pomysłu, robienie story, sprawdzanie wariantów promptu — H3 Max. Około dziesięciu sekund i 200 kredytów za próbę.
Realistycznie wyglądająca osoba w codziennym, niereklamowym ujęciu — Wan 3.0. Dźwięk w cenie, koszt ze środka stawki.
Ożywianie własnego zdjęcia — Kling 3 Pro. Twarze, ubrania i napisy zostają takie jak w kadrze.
Filmowy klip z dźwiękiem jakości filmowej — Veo 3.1, a do szkiców Veo 3.1 Fast.
Złożony ruch — taniec, sport, woda, zmiany ujęć — Seedance Pro, jeśli możesz poczekać i zapłacić więcej.
Modele możesz przełączać od razu w generatorze wideo, na przykład zaczynając od H3 Max. Wideo i obrazy korzystają z tych samych kredytów multimedialnych, a cena klipu jest pokazywana przed startem.
W skrócie
ChatPlus ma dwa nowe modele wideo. H3 Max to przyspieszona przez fal wersja MiniMax H3: klip z dźwiękiem w około dziesięć sekund, 200 kredytów multimedialnych za pięć sekund, 768p. Wan 3.0 od Alibaba daje realistycznych ludzi i naturalny ruch, z dźwiękiem w cenie, 250 kredytów za pięć sekund. Domyślnym modelem obrazów jest teraz GPT Image 2.5 od OpenAI: lepszy w tekście i edycjach, z tymi samymi cenami 10 i 50 kredytów. W naszym teście na jednym prompcie H3 Max był najszybszy, Veo 3.1 najbardziej filmowy, a Seedance Pro najdokładniejszy w ruchu.
Wypróbuj najlepsze modele AI w ChatPlus
GPT, Claude, Gemini, GLM i inne modele AI w jednym oknie.